程序生成训练页
页面与图谱来自同一排版程序
ORACLEGRAPH DATASET · PRISM FRAMEWORK
多模态结构化生成的评测与优化:OracleGraph 数据集与 PRISM 框架
College of Computer Science and Technology, Tongji University
* 共同第一作者† 通讯作者:yechen@tongji.edu.cn
从图像直接生成长 JSON 图谱,要求多模态大语言模型同时保持文本、对象与关系的完整性。本文以古籍页面为研究场景,分析策略层面的信号缺口、零奖励解析断崖和短输出偏置:标量奖励方法在匹配预算下停留在 SFT 附近,普通自蒸馏还可能退化。为研究这些问题,我们提出 OracleGraph:由程序共同生成页面与图谱标注的 10,000 页 2.5D 基准,配套 12 维诊断式 VQA。PRISM 将 DGR 条件化的回顾式教师、奖励加权蒸馏、长度归一化偏好损失和独立教师更新结合起来,改善长结构生成。
论文主表中,PRISM 相比 Vanilla-SDPO 的 Graph Reward 提高 3.81 个百分点(p < 0.001);相对 SFT 的 +1.02pp 差异未达到统计显著性(p = 0.12)。新增分析将收益定位于低质量、长输出和复杂图谱页面,统一消融显示辅助偏好损失有助于减少截断和遗漏。在外部 GraphDoc 数据上重新训练后,Graph F1 提高 2.95pp。这些结果支持 PRISM 对被测结构生成任务的改进,尚不意味着普遍超越 SFT 或解决分布外迁移。
读懂文字之后,还要读懂页面的结构。
古籍页面不是线性的文本:竖排正文、双行夹注、眉批、朱印与跨栏阅读顺序交织在一起。模型需要将这些视觉元素转换成符合 schema 的 JSON 图,明确“谁先读”“谁注释谁”以及“谁遮挡谁”。
一个标量难以定位长 JSON 中的节点、关系和拓扑错误。不可解析的输出会遇到零奖励断崖。
模型可能通过缩短响应规避解析风险;缺少图诊断与奖励感知的教师,也可能传递错误结构。
THE ORACLEGRAPH BENCHMARK
用节点、关系与遮挡层次,刻画古籍中的非线性阅读结构。
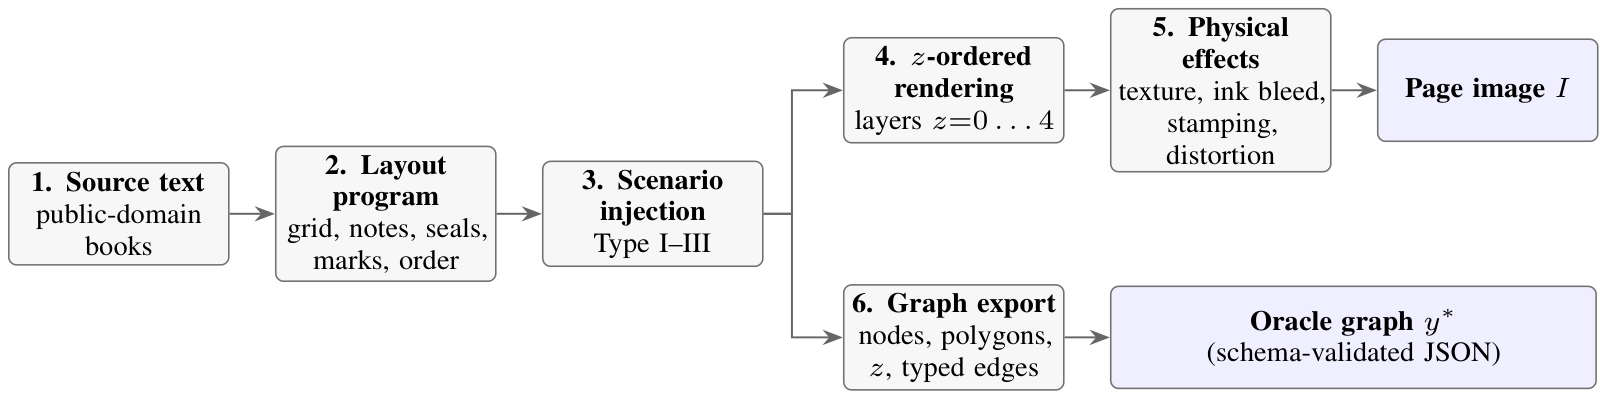
历史排版程序同时决定页面元素、坐标、遮挡层与有向关系,再输出图像和 OracleGraph JSON。图谱相对于生成程序是确定的;主集并非人工图谱标注。论文按 5,000 页训练、500 页 VQA 诊断和 4,500 页压力测试组织 10,000 页基准。
页面与图谱来自同一排版程序
论文使用的留出诊断划分
布局多样性引擎生成
完整 OracleGraph 在二维坐标之外记录离散遮挡层级 z ∈ {0, 1, 2, 3, 4},描述朱印、正文和批注的层叠关系。已发布 LoRA 使用的 compact 输出保留内容节点与主要关系,不直接预测 z-index;完整本体与模型输出的覆盖范围应分别理解。
ModelScope 发布包包含 5,000 页主集、4,500 页压力集,以及保存的全部 529 页 VQA(38,583 问),共 10,029 页。529 页是归档文件数量,不等于论文的 500 页诊断划分。主集另附固定的 4,900/100 训练与验证列表;复现 VQA 时需使用对应实验的选样及评分协议。
建模正文、夹注、眉批、朱印与版面元素等语义实体。
表达 READS_AFTER、ANNOTATES、OVERLAPS 等结构关系。
离散 z-index 使覆盖、层叠与视觉干扰具备可检查的表示。
以基本逻辑、全局元素和高级二维空间推理为三组,分别暴露模型在页面理解中的不同短板。
BVR · HCE · NIR
GQR · EXR · SCR
SVC · CCB · RVR · AGC · MBCV · EFD
论文按节点、关系和结构错误评价长图谱生成。Graph Reward 与全页面 pooled strict F1 的聚合方式不同,不能直接比较绝对值;VQA 的 EXR 使用无序字符重叠,不能代表阅读顺序准确率。阅读关系需要单独评价。
POLICY-REWARD INTEGRATED SELF-DISTILLATION
图诊断、奖励加权与长度归一化偏好约束共同稳定自蒸馏。
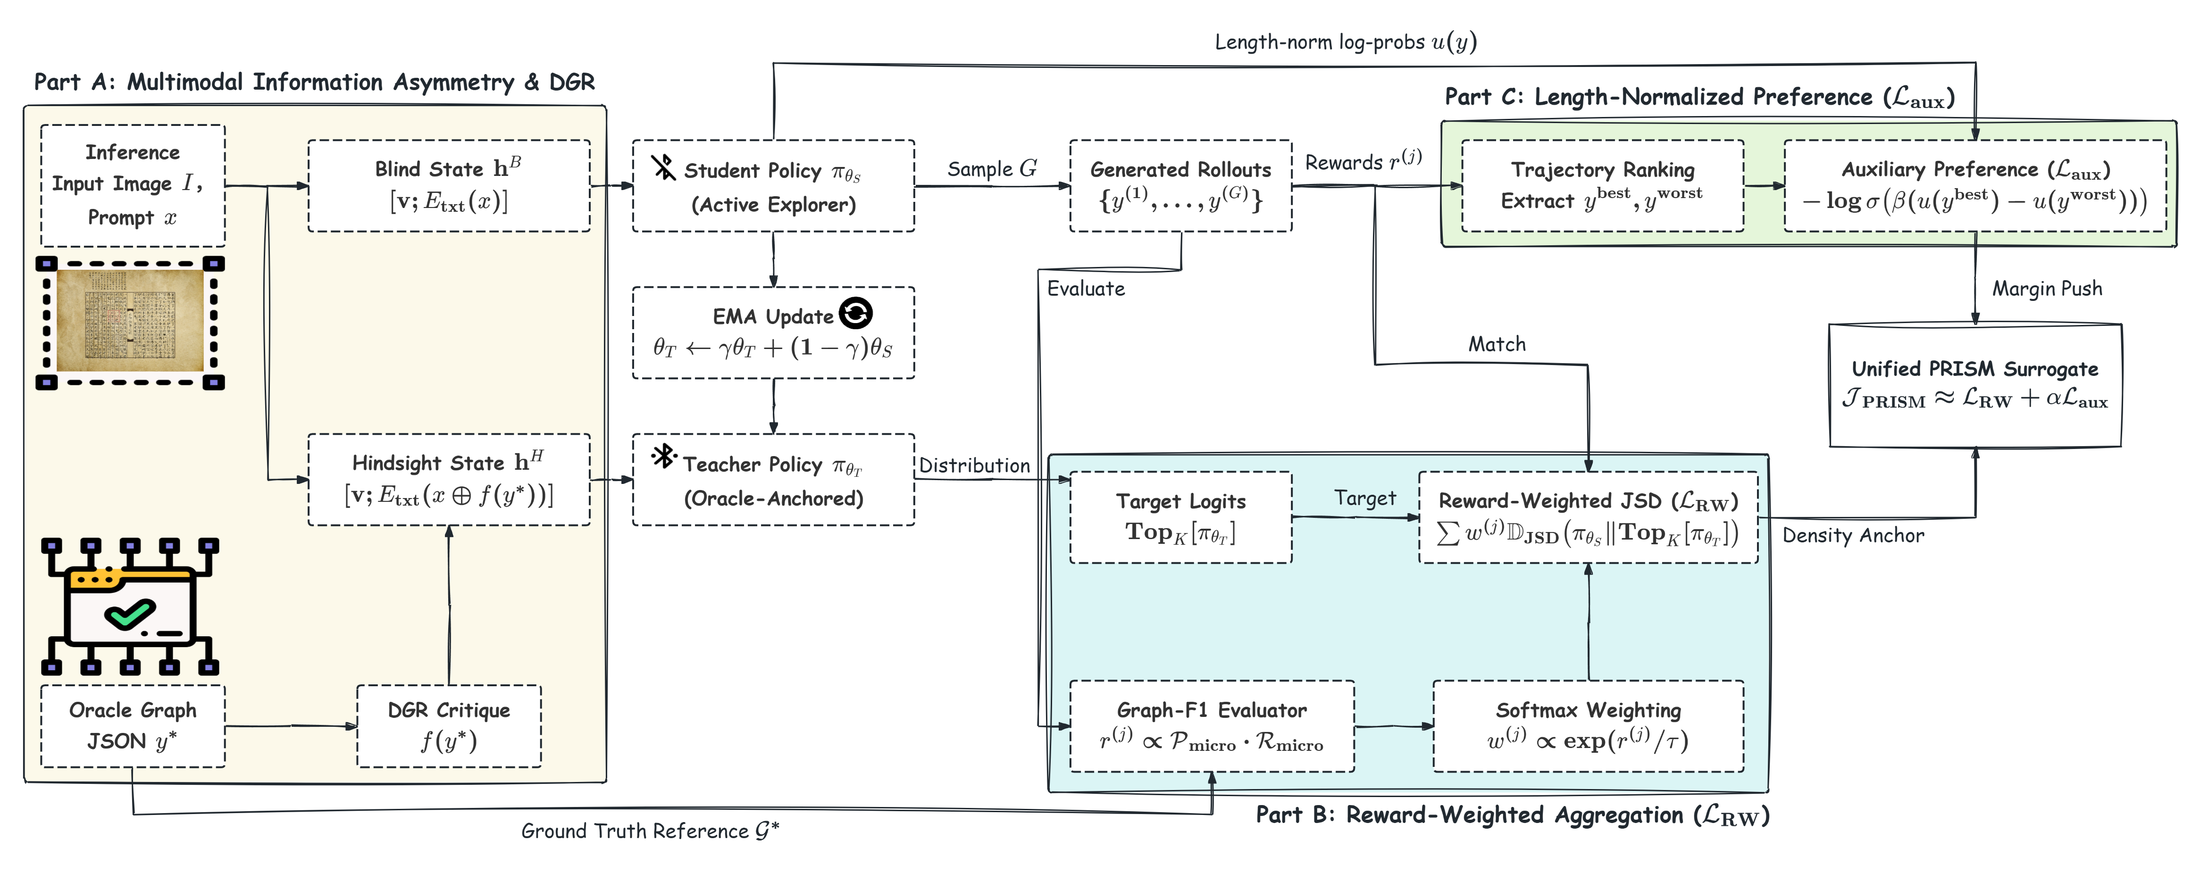
推理时,学生接收图像与提示;训练时,教师额外使用图结构反馈。候选的结构奖励决定蒸馏权重,长度归一化偏好项比较最佳与最差候选。迁移到其他图谱任务需要适配本体、匹配器和反馈内容。
回顾式教师接收基于真值结构的诊断报告,获得拓扑与错误类型信息。盲学生仍需从图像中自主生成,信息差形成有方向的学习信号。
Hindsight Teacher根据 Graph-F1 奖励为 rollout 轨迹分配权重,保留好坏候选的结构排序,降低错误拓扑在蒸馏梯度中的影响。
Reward-Weighted Aggregation比较最佳与最差候选的归一化对数概率,扩大胜负轨迹间隔,并抑制因奖励稀疏而产生的短输出偏置。
Auxiliary Preference LossEMA 让独立教师缓慢跟踪学生。正式稿的匹配消融中,冻结教师与 EMA 的得分近似;两者差异未获统计确认,EMA 是默认更新方式。
Exponential Moving AverageRESULTS & EVALUATION
OracleGraph 主表、诊断式 VQA、GraphDoc 迁移与分布外压力测试。
Graph Reward · 3 seeds
p < 0.001 · Table 3
Graph F1 · 3 seeds
38.21% → 41.16% · Table 20
SFT / PRISM:0.65 / 0.27 pp
3 seeds · Table 3
结果按各表协议阅读:主表为 Graph Reward,统一消融为 pooled strict F1,GraphDoc 使用其官方指标;训练轨迹与验证集结果也分别报告。
LoRA r = 32 · post-SFT 100 步 · 同一组 n = 100 页 · 3 个随机种子
| 方法 | Graph Reward ↑ | 跨种子 std ↓ | Δ vs. SFT | p vs. SFT | 解析率 | 响应长度 |
|---|---|---|---|---|---|---|
| SFT baseline 1,000 步 | 72.94% | 0.65 pp | — | — | 98.0% | 1,337 |
| DPO | 73.64% | 0.39 pp | +0.70 pp | 0.33 | 98.3% | 1,312 |
| GRPO | 73.74% | 1.77 pp | +0.80 pp | 0.41 | 98.0% | 1,338 |
| SimPO | 72.65% | 1.05 pp | −0.29 pp | 0.68 | 96.7% | 1,390 |
| Vanilla-SDPO | 70.15% | 1.73 pp | −2.79 pp | < 0.01 | 94.0% | 1,555 |
| PRISM Ours | 73.96% | 0.27 pp | +1.02 pp | 0.12 | 96.3% | 1,431 |
相对 Vanilla-SDPO 的 +3.81pp 增益显著,95% CI 为 [+1.95, +5.76]pp;相对 SFT 的 +1.02pp 差异不显著(p = 0.12)。标准差比值描述这三次运行的离散程度,不能据此认定普遍或经显著性检验的方差下降。PRISM 的解析率高于 Vanilla-SDPO,低于 SFT。
Avg 为 12 项准确率的非加权均值;Win/12 为严格优于 Qwen2.5-VL-7B 的维度数。
| 模型 | 规模 | Avg ↑ | Win / 12 |
|---|---|---|---|
| Llama-3.2-11B-Vision-Ins | 11B | 2.91% | 0 |
| Gemma-3-12B-IT | 12B | 5.02% | 0 |
| InternVL3-8B | 8B | 3.28% | 0 |
| InternVL2.5-8B | 8B | 3.55% | 0 |
| Qwen2.5-VL-7B-Ins | 7B | 18.90% | 参考 |
| Ovis2-8B | 8B | 13.45% | 2 |
| Qwen3-VL-8B · Base | 8B | 23.41% | 9 |
| Qwen3-VL-8B · SFT | 8B | 26.17% | 10 |
| PRISM · seed 42, step 100 | 8B | 26.05% | 10 |
| PRISM · seed 2024, step 180 | 8B | 25.89% | 10 |
正式稿 Appendix A.6 将结构子集明确为 BVR、HCE 和六项高级空间任务的非加权均值。SFT 为 21.63%,PRISM seed 42 为 21.50%,Qwen3-VL 基础模型为 18.38%,Qwen2.5-VL-7B 为 8.93%。优势已有相当部分来自基础模型和 SFT;PRISM 保持了其诊断能力。12 维均值采用统一版本,不能与按问题数加权的 micro Avg 混用。
两个独立协议,分别评价任务内适配和直接迁移。
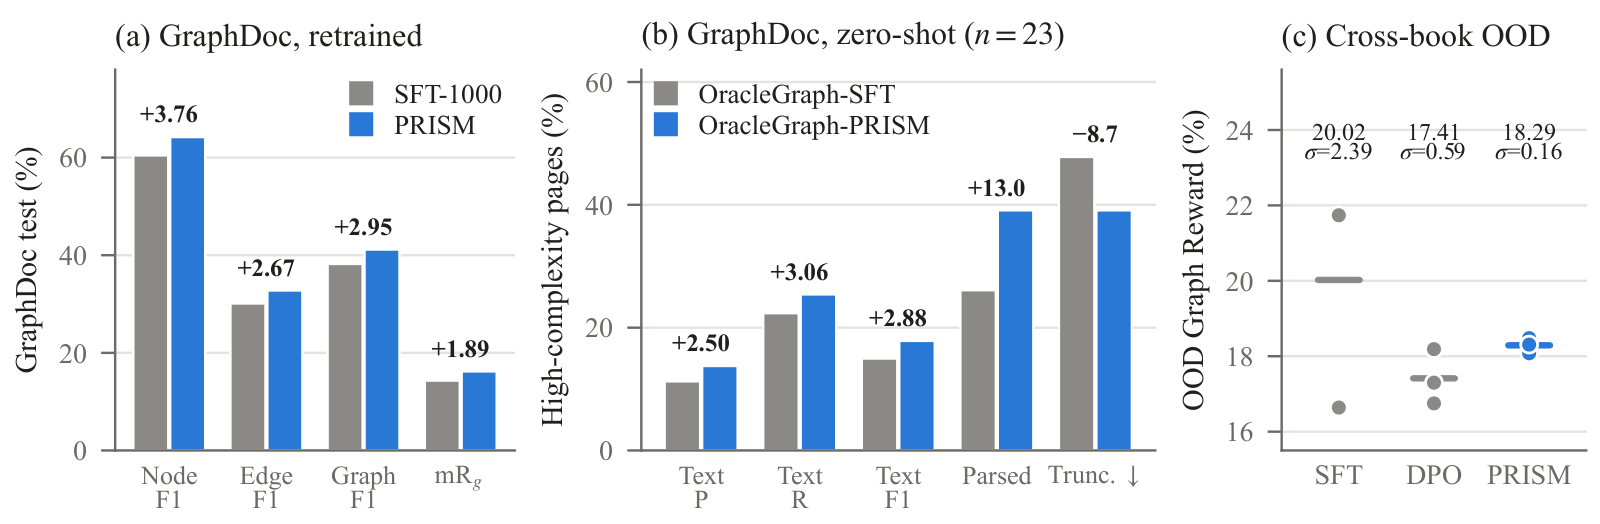
Qwen3-VL-8B · 对应种子 SFT-1000 初始化 · PRISM 20 步 · 3 seeds · 官方 evaluator
| 指标 | SFT-1000 | PRISM | 增益 |
|---|---|---|---|
| Node F1 | 60.44% | 64.20% | +3.76pp |
| Edge F1 | 30.11% | 32.78% | +2.67pp |
| Graph F1 | 38.21% | 41.16% | +2.95pp |
| mRg | 14.31% | 16.20% | +1.89pp |
不更新权重 · 只评价共有文本区域本体 · 高复杂度页 n = 23,gold 文本区域数 > 12
| 指标 | OracleGraph-SFT | OracleGraph-PRISM | 变化 |
|---|---|---|---|
| Text precision | 11.26% | 13.76% | +2.50pp |
| Text recall | 22.35% | 25.41% | +3.06pp |
| Text F1 | 14.97% | 17.85% | +2.88pp |
| 解析率 | 26.1% | 39.1% | +13.0pp |
| 截断率 ↓ | 47.8% | 39.1% | −8.7pp |
| 预测区域数 / 页 | 36.70 | 34.13 | −2.57 |
重新训练结果使用 GraphDoc 自身监督;零样本实验仅对齐共有文本区域,绝对 F1 仍低。这里报告论文中的观测差值,未将其表述为已通过显著性检验或全本体泛化。
《西游记》与《资治通鉴》合成页面 · n = 100 · seeds {42, 7, 2024}
| 方法 | Seed 42 | Seed 7 | Seed 2024 | 跨种子 std ↓ |
|---|---|---|---|---|
| SFT-r32-1000 | 16.64% | 21.69% | 21.74% | 2.39 pp |
| DPO | 16.75% | 17.30% | 18.19% | 0.59 pp |
| PRISM | 18.48% | 18.08% | 18.31% | 0.16 pp |
三种子均值为 SFT 20.02%、DPO 17.41%、PRISM 18.29%,所有成对均值差异均不显著(p ≥ 0.19)。PRISM 在这些运行中的标准差较小,但该探针同时改变文本来源和布局密度。下面的受控实验显示,完整关系恢复仍是共同难点。
每格 25 页 · pooled strict F1 · 来源、密度与交互效应均未统计确认
| 方法 | 西游记 · 低密度 | 西游记 · 高密度 | 资治通鉴 · 低密度 | 资治通鉴 · 高密度 |
|---|---|---|---|---|
| SFT | 0.0024 | 0.0055 | 0.0054 | 0.0045 |
| Vanilla-SDPO | 0.0047 | 0.0042 | 0.0033 | 0.0050 |
| PRISM | 0.0035 | 0.0053 | 0.0067 | 0.0023 |
所有方法的严格 F1 均不高于 0.0067;PRISM−SFT 总体差异为 −0.0006,95% CI [−0.0030, +0.0011]。它与上方 page-averaged Graph Reward 的口径不同。
MECHANISMS & ABLATIONS
难度分解、统一消融与结构完整性分析。
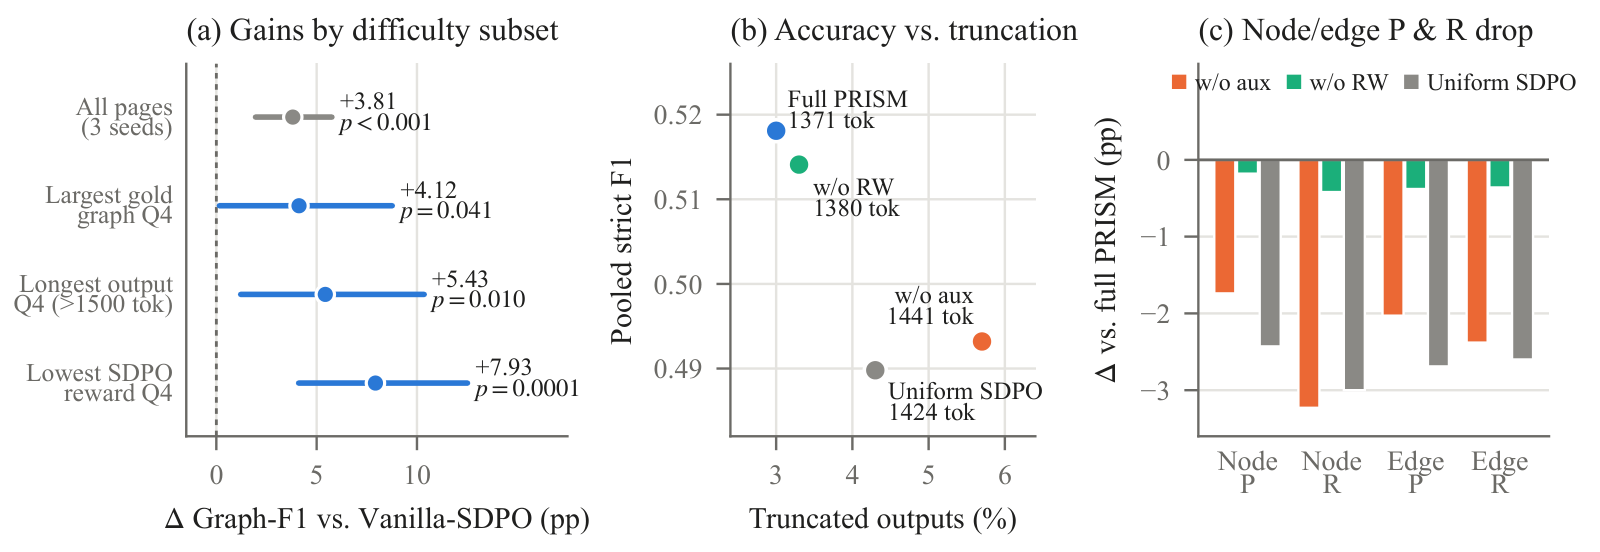
子集各占 25% · 子集分析 5 seeds;全体页参考来自 3 seeds 主表
| 子集 | 增益 | 95% CI | p | 种子方向 |
|---|---|---|---|---|
| 最低 SDPO reward 四分位 | +7.93pp | [+4.10, +12.52] | 0.0001 | 5/5 为正 |
| 最长 SDPO 输出四分位 | +5.43pp | [+1.21, +10.36] | 0.0104 | 5/5 为正 |
| 最大 gold 图谱四分位 | +4.12pp | [+0.15, +8.77] | 0.0405 | 5/5 为正 |
前两组由 SDPO 的结果选出,可能受回归均值影响;最大 gold 图谱组仅由标注定义。子集数字不应与三种子主表当作同一个总体估计,也不能据此宣称对 SFT 显著优效。
相应种子 SFT-1000 初始化 · 固定划分 · r = 32 · 100 步 · 同一 n = 100 页 · 3 seeds
| 配置 | Pooled strict F1 ↑ | Node P / R | Edge P / R | 截断率 ↓ | 输出长度 |
|---|---|---|---|---|---|
| 完整 PRISM · EMA | 0.5181 | 0.7067 / 0.6412 | 0.3812 / 0.3715 | 3.0% | 1,371 |
| 移除辅助损失 · RW only | 0.4932 | 0.6893 / 0.6089 | 0.3609 / 0.3477 | 5.7% | 1,441 |
| 移除奖励加权 · aux only | 0.5141 | 0.7049 / 0.6370 | 0.3774 / 0.3679 | 3.3% | 1,380 |
| Uniform SDPO | 0.4898 | 0.6824 / 0.6112 | 0.3543 / 0.3455 | 4.3% | 1,424 |
| 冻结教师 | 0.5187 | — | 0.3824 / 0.3682 | — | — |
| 在线教师 | 0.5126 | — | 0.3747 / 0.3651 | — | — |
移除辅助损失后,输出更长(1,371 → 1,441 tokens),截断更多(3.0% → 5.7%),严格 F1 更低。完整 PRISM 以更短输出恢复更多节点与关系。冻结教师与 EMA 的差异仅 0.0006,未获统计确认;移除 RW 的增量差异也仍需更多种子验证。
这是三种子消融子矩阵。ModelScope 发布的五种子权重均值为 pooled strict F1 0.5092,两者种子集合不同;不要把它们直接作组件差值。
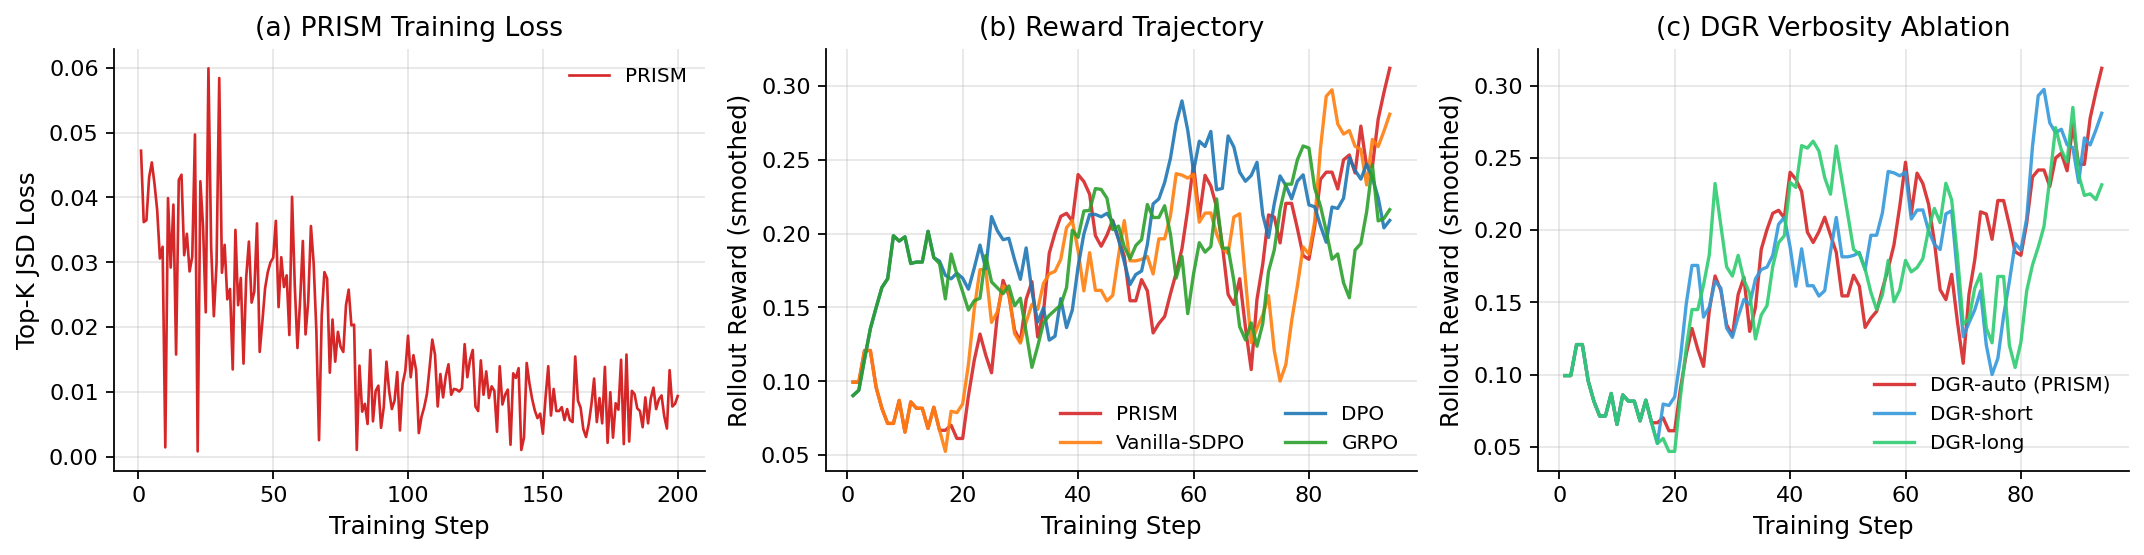
图中的训练时平滑 rollout reward 与独立评测的 Graph Reward 口径不同;SDPO 曲线采用消融中的 short-DGR 代理。最终性能比较以 Table 3 的匹配协议结果为准。
Figure 3 的平滑曲线用于展示训练过程,不能代替独立验证集结论。Appendix B.6 的前后半程汇总中,PRISM 训练 reward 近似持平(−0.004),长度变化为 −0.9%;不据该曲线宣称训练 reward 持续上升。
在匹配 r = 32 协议下,L2 的均值最高;auto 在误差类型间动态选择报告粒度。均值与稳定性需要分别判断。
| DGR 形式 | Graph Reward |
|---|---|
| None | 70.15% ± 1.73 pp |
| L0 | 73.49% ± 1.04 pp |
| L2 | 74.59% ± 1.14 pp |
| L3 | 73.77% ± 0.67 pp |
| short | 73.09% ± 0.93 pp |
| long | 73.12% ± 0.21 pp |
| auto · PRISM | 73.96% ± 0.27 pp |
Table 6。long 的标准差为 0.21pp,低于 auto 的 0.27pp;auto 为默认配置,其均值更高。表格不支持“auto 在所有变体中最稳定”的表述。
相比 SFT,PRISM 的主要增益出现在阅读顺序与遮挡关系上;并非所有类型都同步改善。
ANNOTATES 从 41.8% 降至 40.6%,夹注节点略降。显示值经四舍五入,Δ 沿用论文 Tables 4、18。
r = 32;同分布 n = 100,OOD n = 50。组件行采用 seed 42,Vanilla-SDPO 参考行采用主表三种子均值。
| 方法 | 奖励加权 RW | 辅助偏好 aux | DGR | 同分布 | OOD |
|---|---|---|---|---|---|
| Vanilla-SDPO | — | — | — | 70.15% | 未报告 |
| aux-only | — | ✓ | ✓ | 73.09% | 14.23% |
| rw-only | ✓ | — | ✓ | 69.98% | 13.56% |
| PRISM · full | ✓ | ✓ | ✓ | 73.59% | 20.40% |
Table 19 的 OOD 差异仅来自单种子、50 页子集,属于探索性结果。组件结论优先参考三种子的 Table 5;此处不能与 Table 16 的 100 页 OOD 均值混用。
PRISM 在被测设置中缓解普通自蒸馏退化,收益集中于长输出、复杂图谱和节点/关系完整性;在 GraphDoc 上重新训练也观察到正向增益。相对 SFT 的总体优势需要按各实验分别判断。
OracleGraph 主表相对 SFT 的均值差异未显著;严格 OOD 图谱恢复接近零;外部证据目前限于一个 GraphDoc 基准。训练需要结构监督或验证器,真实档案扫描的泛化仍需单独验证。